GPTBot, ClaudeBot, PerplexityBot : faut-il bloquer les crawlers IA ?
Depuis l’essor des IA génératives, une nouvelle génération de robots parcourt le web : GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended, Applebot-Extended et bien d’autres. Face à eux, les propriétaires de sites se divisent. Certains les bloquent pour protéger leurs contenus, d’autres les accueillent pour gagner en visibilité. La bonne décision dépend de votre modèle économique, mais une chose est sûre : bloquer sans comprendre peut vous rendre invisible dans les réponses des IA.
Deux familles de robots aux rôles différents
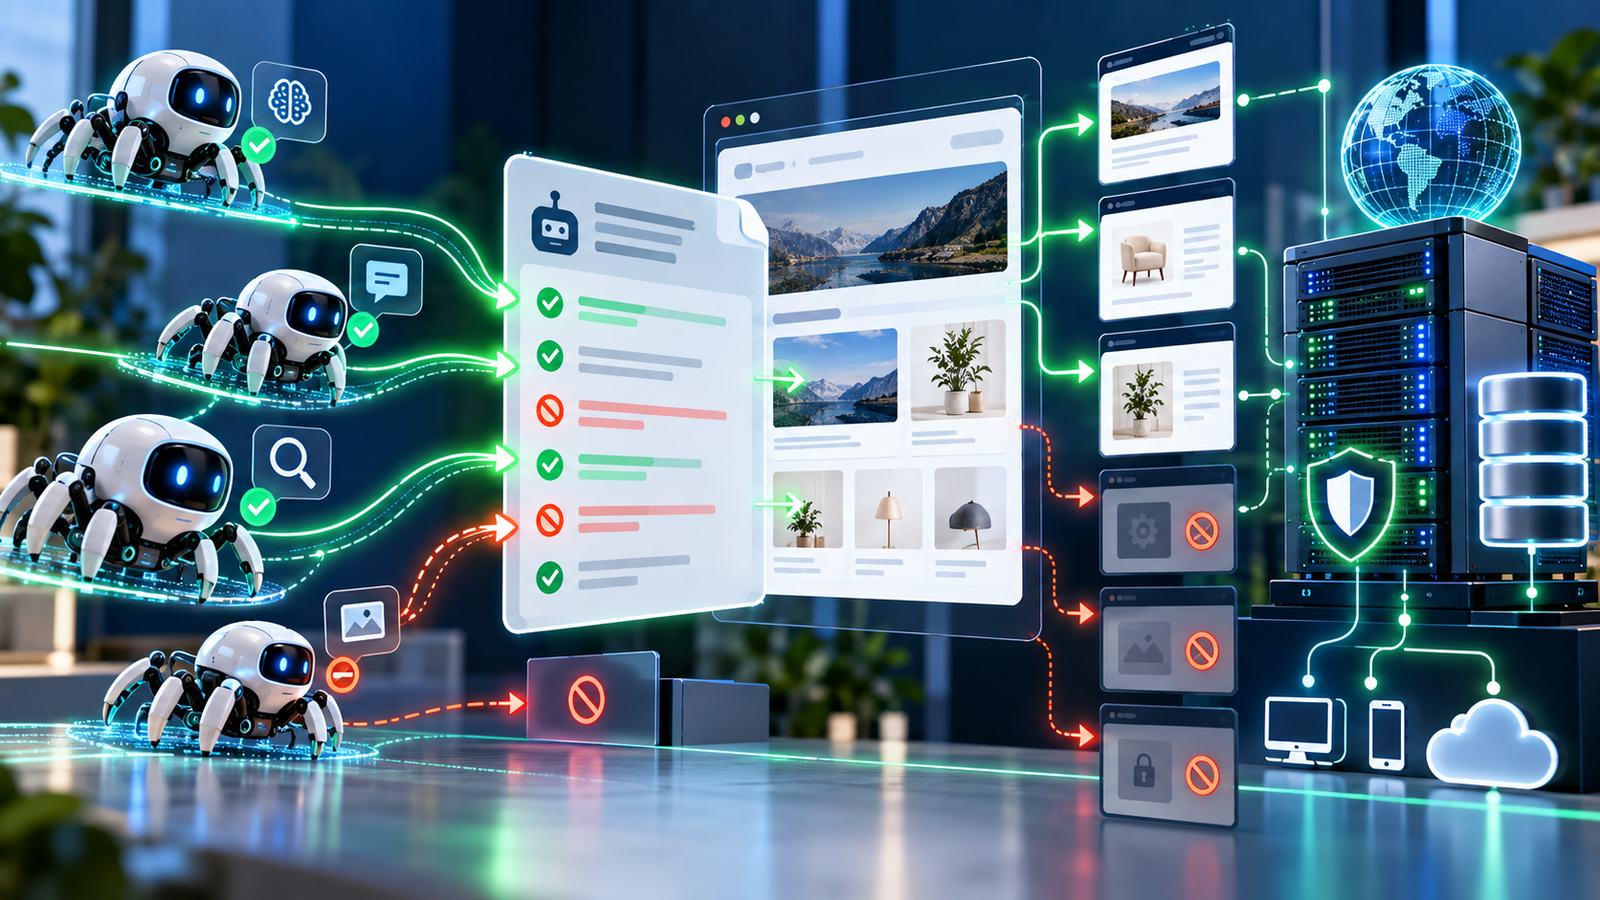
Il est essentiel de distinguer deux usages :
Les robots d’entraînement collectent des contenus pour entraîner ou améliorer les modèles de langage. Les bloquer empêche (pour l’avenir) l’utilisation de vos contenus dans l’entraînement, mais n’a pas d’effet immédiat sur les réponses en recherche.
Les robots de recherche et de récupération consultent vos pages en temps réel pour répondre aux questions des utilisateurs et citer des sources. Les bloquer empêche vos pages d’être citées dans les réponses des outils concernés.
Plusieurs éditeurs d’IA séparent désormais clairement ces usages avec des robots distincts, ce qui permet des réglages fins.
Les principaux robots à connaître
| Robot | Éditeur | Usage principal |
|---|---|---|
| GPTBot | OpenAI | Collecte pour l’entraînement des modèles |
| OAI-SearchBot | OpenAI | Recherche et citations dans ChatGPT |
| ChatGPT-User | OpenAI | Visites déclenchées par une demande d’utilisateur |
| ClaudeBot | Anthropic | Collecte pour l’entraînement |
| Claude-SearchBot / Claude-User | Anthropic | Recherche et récupération à la demande |
| PerplexityBot | Perplexity | Indexation pour les réponses de Perplexity |
| Google-Extended | Jeton contrôlant l’usage pour l’entraînement de Gemini | |
| Applebot-Extended | Apple | Jeton contrôlant l’usage pour l’entraînement des modèles Apple |
| CCBot | Common Crawl | Constitution d’un corpus public utilisé par de nombreux modèles |
Les noms et rôles évoluent régulièrement : consultez la documentation officielle de chaque éditeur avant toute modification.
Point important concernant Google : Google-Extended ne concerne pas la recherche. Bloquer ce jeton n’empêche pas vos pages d’apparaître dans les AI Overviews, qui dépendent de Googlebot. Et bloquer Googlebot vous retirerait tout simplement de Google.
Les arguments pour bloquer
- Protéger un contenu à forte valeur : médias, éditeurs, bases de données payantes dont le modèle repose sur la vente de l’information.
- Réduire la charge serveur : certains robots peuvent être très actifs sur de gros sites.
- Négocier : des éditeurs bloquent pour conserver un levier dans d’éventuels accords de licence.
Les arguments pour autoriser
- La visibilité : un site bloqué ne peut pas être cité par les moteurs concernés, ni générer de trafic depuis leurs réponses.
- La représentation de la marque : si les IA ne peuvent pas lire votre site, elles décrivent votre entreprise à partir de sources tierces, parfois inexactes ou obsolètes.
- La présence à long terme : les contenus accessibles contribuent à ce que les futurs modèles connaissent votre marque.
Notre recommandation selon votre profil
Pour la plupart des entreprises (sites vitrines, services, e-commerce, SaaS) : autorisez tous les robots IA. Votre contenu est avant tout un outil d’acquisition ; vous avez intérêt à ce qu’il soit lu, compris et cité le plus largement possible.
Pour les éditeurs de contenu monétisé : une approche nuancée est possible. Bloquer les robots d’entraînement tout en autorisant les robots de recherche permet de rester citable sans alimenter gratuitement l’entraînement des modèles.
Exemple de configuration robots.txt
Pour autoriser la recherche mais refuser l’entraînement :
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: PerplexityBot
Allow: /
Pour tout autoriser, il suffit de ne pas mentionner ces robots, à condition qu’aucune règle générale ne les bloque.
Le piège du blocage involontaire
Dans nos audits, le cas le plus fréquent n’est pas un blocage volontaire, mais involontaire :
- des protections anti-bots activées par défaut chez l’hébergeur ou le CDN, qui bloquent les robots IA ;
- des règles de pare-feu trop larges ;
- des extensions de sécurité WordPress qui filtrent les agents utilisateurs inconnus ;
- des pages qui renvoient des erreurs ou des défis de vérification aux robots.
Le robots.txt peut autoriser l’accès alors que le serveur le refuse en pratique. Seule l’analyse des logs serveur permet de vérifier que les robots accèdent réellement à vos pages et reçoivent une réponse valide.
FAQ
Tous les robots IA respectent-ils le robots.txt ?
Les principaux éditeurs déclarent le respecter. Pour les robots qui ne le respectent pas, seules des règles au niveau du serveur ou du pare-feu sont efficaces.
Bloquer GPTBot me retire-t-il de ChatGPT ?
Pas des résultats de recherche si OAI-SearchBot reste autorisé. En revanche, vos futurs contenus ne contribueront pas à l’entraînement des modèles d’OpenAI.
À quelle fréquence revoir ces réglages ?
Au moins deux fois par an, car de nouveaux robots apparaissent et les éditeurs modifient leurs politiques.
Vos pages sont-elles vraiment accessibles aux IA ? Absolute Référencement analyse vos logs serveur, votre robots.txt et votre configuration de sécurité pour garantir que les bons robots accèdent à vos contenus. Demandez un audit technique GEO.